农业科技领域畅销的数据策略
 2026年九月24日
几年前,我们建立了一个模型,利用Sentinel-2影像估算覆盖作物生物量。该模型的R²值为0.72。从理论上讲,这是一个不错的模型。好到可以放在幻灯片上展示,好到可以向客户报价。.
它错了两次。.
第一个问题在于数据的划分方式。真实数据来自实地考察,每次考察从每个田块采集两个样本单元,有时相距50米。随机的训练/测试划分方式导致其中一个单元被纳入训练集,而另一个单元则被纳入测试集。模型并非被要求预测一个全新的田块,而是被要求预测一个几乎与它之前采集过的田块重合的位置。.
第二个问题更难察觉。模型选取的10个卫星特征中,有9个的年代晚于生物量测量日期,其中一个甚至晚了124天。这听起来似乎不可思议,但了解田地的管理方式后就容易理解了。覆盖作物会在采样后数周或数月被清除,而我们的研究表明,曾经拥有密集生物量的田地在清除后会留下更明显的裸土特征。模型似乎已经掌握了清除后的土壤特征。对于同期估算而言,它实际上是在预测未来以推断过去。.
在 R² 为 0.72 的情况下,这两者都不明显。这就是这个数值的问题所在。.
当我们重建模型并进行适当测试后,得分取决于我们保留了哪些数据:
| 我们坚持了下来 | R² |
| 随机选择抽样单元 | 0.72 |
| 整片田地 | 0.47 |
| 一个完整的合作社,一片新的地理区域 | 0.07 |
| 整整一个季度,这位模特从未见过 | −0.13 |
最后一个数值低于零。负的 R² 值意味着该模型的表现还不如忽略卫星数据并预测每个样本当季平均生物量。.
这四行数据中,模型规格没有任何变化,只有问题本身发生了改变。. 它能否填补已采样点之间的空白?它能否处理已知区域附近的新区域?新的区域?新的季节? 这四个问题都很合理。.
哪种方式更接近实际部署取决于产品。销往新地区的模型需要进行地域性测试集保留。预期明年投入使用的模型需要进行时间性测试集保留。随机划分的训练集和测试集都无法满足上述任何要求,但它却最有可能出现在幻灯片上,因为这是默认训练/测试集划分的结果。.
如果诚实地进行重建,消除漏洞,并在评估过程中排除赛季训练的影响,它就能恢复到 0.42。我们对 0.42 的信任程度,远胜于我们对 0.72 的信任程度。.
改变我们保留的内容使得分提高了 0.85。改变模型,用 60 天的图像序列对比单张图像,使得分提高了 0.07。.
一个模型,三种对“好”的定义
主题是一个没有单位的数字,很少有哪个行业比这个行业遇到更多这样的数字,每个功效声明、每个侦察平台和每个产量响应模型都附带一个准确度数字,但这些数字实际发挥的作用远不如表面看起来那么大。.
准确与否取决于谁掌握了模型,而且这种变化的方向相反。.
经销商的农艺服务部门在决定派巡查员去哪里时,需要提前几周收到田间标记。误报会导致半天的巡查,而漏报则可能错过施药窗口期、造成种植者难以忘怀的产量损失,甚至导致销售流失。因此,你不得不容忍研究人员都难以接受的误报率,并为此购买检测服务。.
一家作物保护或生物制品公司在展示产品性能时,提出的问题有所不同。它并非对单个试验地块进行评分,而是估算整个试验网络的平均响应。模型可能擅长前者,却不擅长后者。随着试验地块数量的增加,独立试验地块间的误差会减小,但具有相同季节、区域或加工版本的试验地块间的共享误差不会减小,系统性地压缩极端值的趋势也不会减小。排行榜无法告诉你你面临的是哪种情况。.
负责耐药性监测或标签合规性的监管或市场准入职能部门需要具备可辩护性。误报可能导致合规性问题,而且可追溯性可能比提前响应时间更为重要。.
同一个模型适用于这三个人,但他们对“好”的定义却各不相同。.
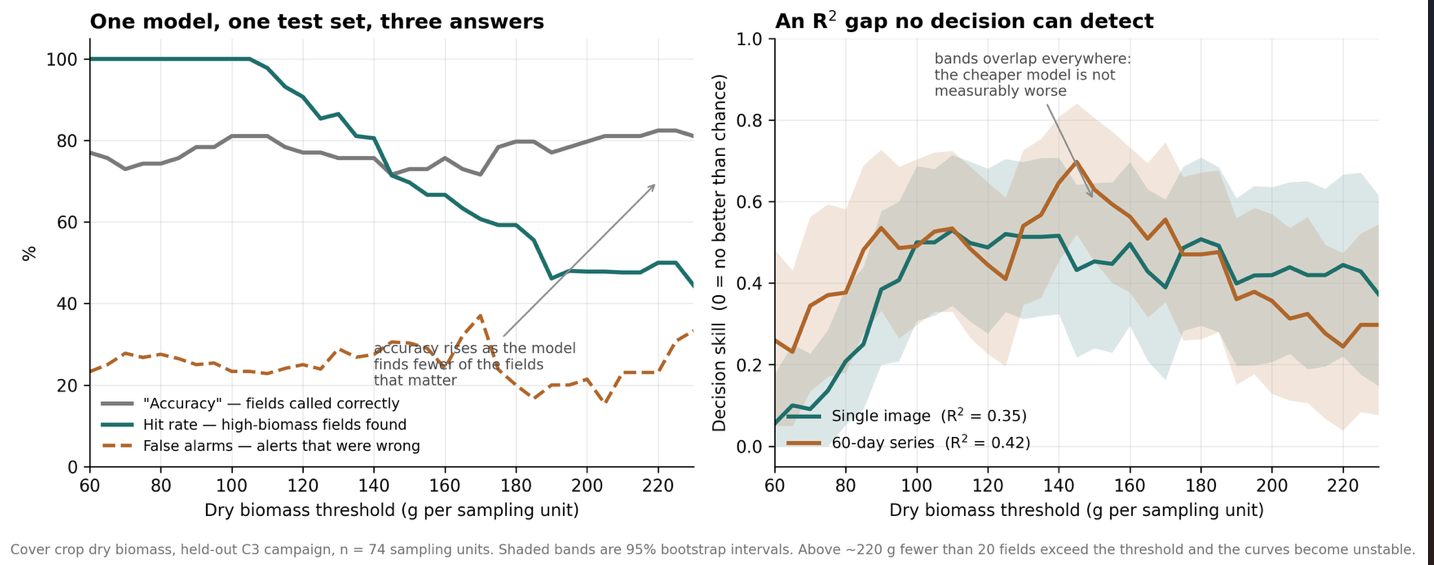
左图:随着决策阈值的变化,一个模型的得分方式有三种,准确率随着命中率的降低而上升。右图:两个模型的 R² 值相差 0.07,它们的 95% 自举带在整个工作范围内重叠。来源:EarthDaily 分析
比什么更好?
还有一个问题,这个问题被问到的频率更低,但对于这个行业来说,它比第一个问题更重要。.
所有关于准确性的声明都是一种比较,而比较对象通常被忽略。在判断一个模型是否优秀之前,你需要知道它优于哪些标准。根据定义,R² 为零意味着模型预测的每个样本的生物量都等于评估集的平均生物量。对于实际应用基准而言,比较对象应该是预测之前已有的数据:历史平均值、上一轮试验的数据、农艺师的估算值,或者买方已经采用的任何方法。.
这是买家可以采取行动的版本,因为买家已经有办法做到这一点,无论是人工取样、农艺师的判断,还是去年的方案。.
如果把“模型”换成“生物学”,再读一遍那段文字,你就会发现该行业面临的核心商业障碍。“产品有效”本身并不是一个可验证的说法。“在这样的土壤、气候和时间条件下,它比现有方案的效果好得多,足以抵消每公顷的成本”这样的说法,才有人能够提出。.
生物制剂田间表现不稳定的问题几乎完全被归咎于产品本身的问题。但实际上,很大一部分原因在于证据不足。重复试验只能证明某种处理方法在试验网络所代表的环境中有效,但这并不等同于证明该效果能够转移到新的地理区域、管理系统或季节。.
证据往往导致了错误的比较,因为与未处理的对照组相比,产品的效果表明它确实有效,而购买决策则取决于它在种植者现有方案基础上增加了什么。更好的品种并不能解决这两个问题。.
四个问题
这并非意味着准确率指标毫无用处,只是不够全面。没有具体说明的数字并非结论,而只是一种形状。因此,当有人向你展示准确率数据时,四个问题就能帮你了解大部分情况。.
- 你到底藏着什么秘密? 随机样本、整个领域、一个地区、一个季节?
- 你打败了什么? 不是评估集均值,这只是 R² 的起点,而是相对于买方今天所做的任何操作,以买方的单位表示。.
- 你遇到的最糟糕的情况是什么?(不是平均情况)
- 误报会给我带来什么损失? 只有客户才能回答这个问题,因为它取决于他们自身的经济状况,而不是模型中的任何因素。也正因如此,这个问题在有供应商在场的情况下才显得尤为重要。.
两家供应商可以对阈值设定值存在分歧,而无需承认各自的模型存在缺陷。值得询问一下你所用模型的相关文档是如何规定的。.
立即获取时事通讯!