Estratégias de dados que vendem no setor de tecnologia agrícola.
 24 de setembro de 2026
Há alguns anos, desenvolvemos um modelo para estimar a biomassa de plantas de cobertura a partir de imagens do Sentinel-2. Ele apresentou um R² de 0,72. Teoricamente, é um bom modelo. Bom o suficiente para ser apresentado em um slide, bom o suficiente para ser citado a um cliente.
Errou duas vezes.
O primeiro problema foi a forma como os dados foram divididos. Os dados de referência foram obtidos em campanhas de campo que coletaram duas unidades de amostragem em cada campo, às vezes com 50 metros de distância entre elas. Uma divisão aleatória entre treino e teste permite que uma dessas unidades seja usada para treinamento enquanto a outra é usada para teste. O modelo não estava sendo solicitado a prever um novo campo, mas sim um ponto quase idêntico a um ponto onde já havia sido utilizado.
O segundo problema era mais difícil de perceber. Nove das dez características de satélite selecionadas pelo modelo foram datadas após o dia em que a biomassa foi medida, uma delas com 124 dias de atraso. Isso parece impossível até que se saiba como os campos são manejados. As culturas de cobertura são eliminadas semanas ou meses após a coleta das amostras, e nossa análise indica que um campo com biomassa densa deixa uma marca mais nítida de solo exposto após a destruição. O modelo parecia ter aprendido com as consequências. Para uma estimativa contemporânea, ele estava prevendo o passado a partir do futuro.
Nenhuma dessas duas características é visível em um R² de 0,72. Esse é todo o problema com esse número.
Quando reconstruímos o modelo e o testamos adequadamente, a pontuação dependeu do que excluímos:
| O que nós resistimos | R² |
| Uma seleção aleatória de unidades de amostragem | 0.72 |
| Campos inteiros | 0.47 |
| Uma cooperativa inteira, uma nova geografia. | 0.07 |
| Uma temporada inteira que a modelo nunca tinha visto. | −0,13 |
O último valor é inferior a zero. Um R² negativo significa que o modelo teve um desempenho pior do que ignorar os dados de satélite e prever a biomassa média daquela estação para cada amostra.
Nada mudou na especificação do modelo entre essas quatro linhas. Apenas a pergunta mudou. Consegue preencher as lacunas entre os pontos que já amostrou? Consegue lidar com um novo campo próximo a outros que já conhece? Uma nova região? Uma nova estação do ano? Todas as quatro são perguntas legítimas.
Qual deles representa a implantação depende do produto. Um modelo vendido em novas regiões precisa de validação geográfica. Um modelo que se espera que funcione no próximo ano precisa de validação temporal. Uma divisão aleatória por pontos não responde a nenhuma dessas perguntas, mas é a que tem maior probabilidade de chegar ao slide, pois é o que uma divisão padrão entre treino e teste proporciona.
Reconstruído honestamente, com o vazamento corrigido e a temporada mantida fora dos treinos para avaliação, ele se recupera para 0,42. Confiamos em 0,42 de uma forma que nunca deveríamos ter confiado em 0,72.
Alterar o que usamos como parâmetro elevou a pontuação em 0,85. Alterar o modelo, comparando uma série de imagens de 60 dias com uma única imagem, elevou a pontuação em 0,07.
Um modelo, três definições de bem
O assunto é um número sem unidades, e poucas indústrias se deparam com tantos números assim quanto esta, onde cada alegação de eficácia, cada plataforma de monitoramento e cada modelo de resposta de rendimento chegam acompanhados de um índice de precisão que, na verdade, não faz tanto trabalho quanto aparenta.
O que é considerado preciso muda conforme quem está segurando o modelo, e as mudanças ocorrem em direções opostas.
O serviço agronômico de um distribuidor, ao decidir para onde enviar seus técnicos, exige alertas em nível de campo com algumas semanas de antecedência. Um falso positivo custa uma visita de meio dia. Um falso negativo pode significar a perda da janela de aplicação, uma colheita memorável para o produtor e uma venda. Portanto, você tolera uma taxa de falsos alarmes que envergonharia um pesquisador, e paga por isso com a detecção.
Uma empresa de proteção de cultivos ou de produtos biológicos que demonstra o desempenho de um produto está fazendo uma pergunta diferente. Ela não está avaliando parcelas individuais, mas sim estimando uma resposta média em uma rede de ensaios. Um modelo pode ser bom em uma coisa e ruim em outra. O erro entre locais independentes diminui à medida que novos locais são adicionados, mas o erro compartilhado entre locais que têm uma safra, uma região ou uma versão de processamento em comum não diminui, assim como a tendência sistemática de comprimir os extremos. Uma tabela de classificação não pode dizer qual tipo de erro você tem.
Uma função de gestão ou acesso ao mercado que realiza monitoramento de resistência ou conformidade de rótulos precisa de justificativa. Alarmes falsos podem acarretar consequências para a conformidade, e a rastreabilidade pode ser mais importante do que o prazo de entrega.
O mesmo modelo serve para os três, e nenhum deles entende a mesma coisa por "bom".
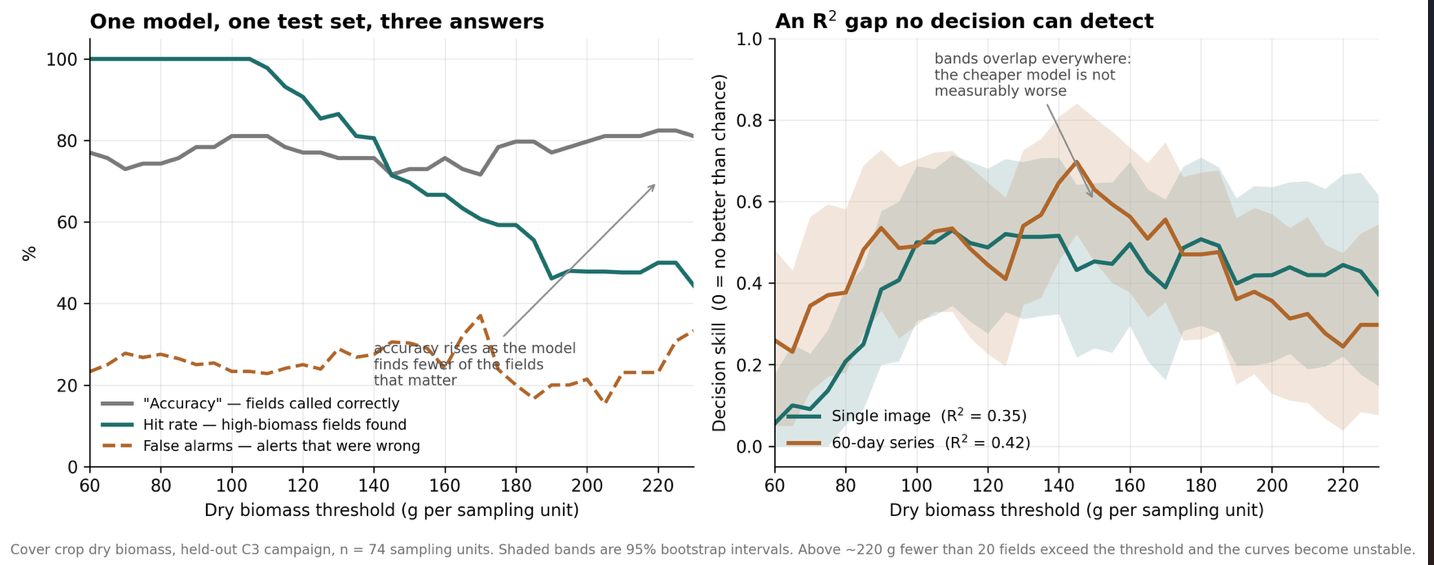
À esquerda: Um modelo pontuado de três maneiras à medida que o limiar de decisão se move, com a precisão aumentando conforme a taxa de acerto diminui. À direita: Dois modelos com diferença de 0,07 no R², cujas bandas de bootstrap 95% se sobrepõem em toda a faixa operacional. Fonte: Análise do EarthDaily
Melhor do que o quê?
Existe uma segunda pergunta que é feita ainda menos frequentemente, e para este setor, ela importa mais do que a primeira.
Toda alegação de precisão é uma comparação, e essa comparação geralmente é omitida. Antes de afirmar que um modelo é bom, é preciso saber o que ele supera. Por definição, um R² igual a zero corresponde à previsão da biomassa média do conjunto de avaliação para cada amostra. Para um benchmark operacional, a comparação deve ser algo disponível antes da previsão: uma média histórica, a campanha anterior, a estimativa de um agrônomo ou qualquer outro dado já utilizado pelo comprador.
É a versão que o comprador pode utilizar porque ele já tem uma maneira de fazer isso, seja por meio de uma amostra manual, da avaliação de um agrônomo ou do programa do ano passado.
Leia esse parágrafo novamente, substituindo o modelo por um exemplo biológico, e você terá o principal obstáculo comercial do setor. "O produto funciona" não é uma afirmação testável da forma como está formulada. "Nestas condições de solo, clima e tempo, ele proporciona essa resposta em comparação com o programa atual, o que compensa seu custo por hectare" é uma afirmação que alguém pode fazer.
O desempenho inconsistente de produtos biológicos em campo é discutido quase que exclusivamente como um problema do produto. Boa parte do problema reside na falta de evidências. A replicação estabelece que um tratamento funciona nos ambientes representados por uma rede de ensaios, o que não equivale a comprovar que o efeito se transfere para uma nova geografia, sistema de manejo ou estação do ano.
As evidências também tendem a levar a comparações equivocadas, já que a resposta em relação a um controle não tratado demonstra que um produto tem alguma eficácia, enquanto a decisão de compra se baseia no que ele agrega ao programa que o produtor já utiliza. Uma cepa melhor não resolverá nenhum desses problemas.
Quatro perguntas
Isso não torna as métricas de precisão inúteis, apenas incompletas. Um número sem um protocolo não é uma afirmação, é apenas uma forma. Portanto, quando alguém lhe mostra um valor de precisão, quatro perguntas já são suficientes para compreendê-lo melhor.
- O que você escondeu? Uma amostra aleatória, um campo inteiro, uma região, uma estação do ano?
- O que você derrotou? Não a média do conjunto de avaliação, que é apenas o ponto de partida do R², mas sim em relação ao que o comprador faz hoje, nas unidades do comprador.
- Qual foi o seu pior cenário, não a média?
- Qual o custo de uma chamada errada? Somente o cliente pode responder a essa pergunta, pois ela se baseia em seus próprios fatores econômicos, e não em algo interno do modelo. É também por isso que a pergunta é útil em uma reunião com um fornecedor.
Dois fornecedores podem discordar sobre onde o limite deve ser definido sem que nenhum deles precise admitir que seu modelo é ruim. Vale a pena perguntar o que diz a documentação do seu modelo.
Receba a Newsletter hoje mesmo!