Estrategias de datos que venden en la tecnología agrícola
 24 de septiembre de 2026
Hace unos años, desarrollamos un modelo para estimar la biomasa de cultivos de cobertura a partir de imágenes de Sentinel-2. El resultado fue un R² de 0,72. En teoría, es un buen modelo. Lo suficientemente bueno como para incluirlo en una diapositiva y para presentarlo a un cliente.
Se equivocó dos veces.
El primer problema radicaba en cómo se habían dividido los datos. La información de referencia provenía de campañas de campo que tomaban dos unidades de muestreo de cada parcela, a veces separadas por 50 metros. Una división aleatoria entre entrenamiento y prueba permitía que una de esas unidades se utilizara para el entrenamiento, mientras que la otra se utilizaba para la prueba. Al modelo no se le pedía que predijera una parcela nueva, sino una ubicación prácticamente idéntica a una que ya había explorado.
El segundo problema era más difícil de detectar. Nueve de las diez características satelitales que seleccionó el modelo tenían una fecha posterior a la del día en que se midió la biomasa, una de ellas con una diferencia de 124 días. Esto parece imposible hasta que se conoce el manejo de los campos. Los cultivos de cobertura se eliminan semanas o meses después del muestreo, y nuestra interpretación es que un campo con biomasa densa deja una huella de suelo desnudo más marcada una vez destruido. El modelo parecía haber aprendido las consecuencias. Para una estimación contemporánea, estaba interpretando el futuro para predecir el pasado.
Ninguna de esas dos cosas es visible en un R² de 0,72. Ese es el problema principal con ese número.
Cuando reconstruimos el modelo y lo probamos correctamente, la puntuación dependió de lo que mantuvimos en reserva:
| Lo que mantuvimos | R² |
| Una selección aleatoria de unidades de muestreo | 0.72 |
| Campos enteros | 0.47 |
| Toda una cooperativa, una nueva geografía | 0.07 |
| Toda una temporada que la modelo nunca había visto | -0,13 |
La última cifra es inferior a cero. Un R² negativo significa que el modelo tuvo un rendimiento peor que ignorar los datos satelitales y predecir la biomasa promedio de esa temporada para cada muestra.
No hubo cambios en las especificaciones del modelo entre esas cuatro filas. Solo cambió la pregunta. ¿Puede cubrir los huecos entre los puntos que ya ha muestreado? ¿Puede abarcar un nuevo terreno cerca de los que ya conoce? ¿Una nueva región? ¿Una nueva temporada? Las cuatro son preguntas legítimas.
La que mejor se ajuste a la implementación depende del producto. Un modelo vendido en nuevas regiones requiere una prueba de validación geográfica. Un modelo que se espera que funcione el próximo año requiere una prueba de validación temporal. Una división aleatoria de puntos no resuelve ninguna de las dos, pero es la que tiene más probabilidades de llegar a la diapositiva porque es la que proporciona una división predeterminada de entrenamiento/prueba.
Reconstruido honestamente, con la fuga eliminada y la temporada sin entrenamientos para la evaluación, se recupera hasta 0,42. Confiamos en 0,42 de una manera que nunca deberíamos haber confiado en 0,72.
Cambiar lo que mantuvimos en reserva modificó la puntuación en 0,85. Cambiar el modelo, una serie de imágenes de 60 días frente a una sola imagen, la modificó en 0,07.
Un modelo, tres definiciones de bien
El tema es un número sin unidades, y pocas industrias se topan con más de ellos que esta, donde cada afirmación de eficacia, cada plataforma de exploración y cada modelo de rendimiento-respuesta viene con una cifra de precisión adjunta que hace menos trabajo del que parece.
Lo que se considera preciso cambia según quién tenga el modelo, y los cambios se producen en direcciones opuestas.
El servicio agronómico de un distribuidor, al decidir dónde enviar a sus técnicos, necesita alertas a nivel de campo con varias semanas de anticipación. Un falso positivo implica una visita de medio día. Un falso negativo puede costar la pérdida de una ventana de aplicación, una cosecha que el agricultor recordará y una venta. Por lo tanto, se tolera una tasa de falsas alarmas que avergonzaría a cualquier investigador, y a cambio se obtiene la capacidad de detección.
Una empresa de protección de cultivos o biológica que demuestra el rendimiento de sus productos se plantea una cuestión diferente. No evalúa parcelas individuales, sino que estima una respuesta promedio en una red de ensayos. Un modelo puede ser eficaz en un aspecto y deficiente en el otro. El error independiente entre sitios disminuye a medida que se añaden más, pero el error compartido entre sitios que comparten una temporada, una región o una versión de procesamiento no lo hace, al igual que la tendencia sistemática a comprimir los extremos. Una tabla de clasificación no puede indicar qué tipo de error se está aplicando.
Una función de gestión o acceso al mercado que supervise la resistencia o el cumplimiento del etiquetado necesita solidez. Las falsas alarmas pueden tener consecuencias negativas en materia de cumplimiento normativo, y la trazabilidad puede ser más importante que el plazo de entrega.
El mismo modelo sirve para los tres, y ninguno de ellos entiende lo mismo por "bueno".
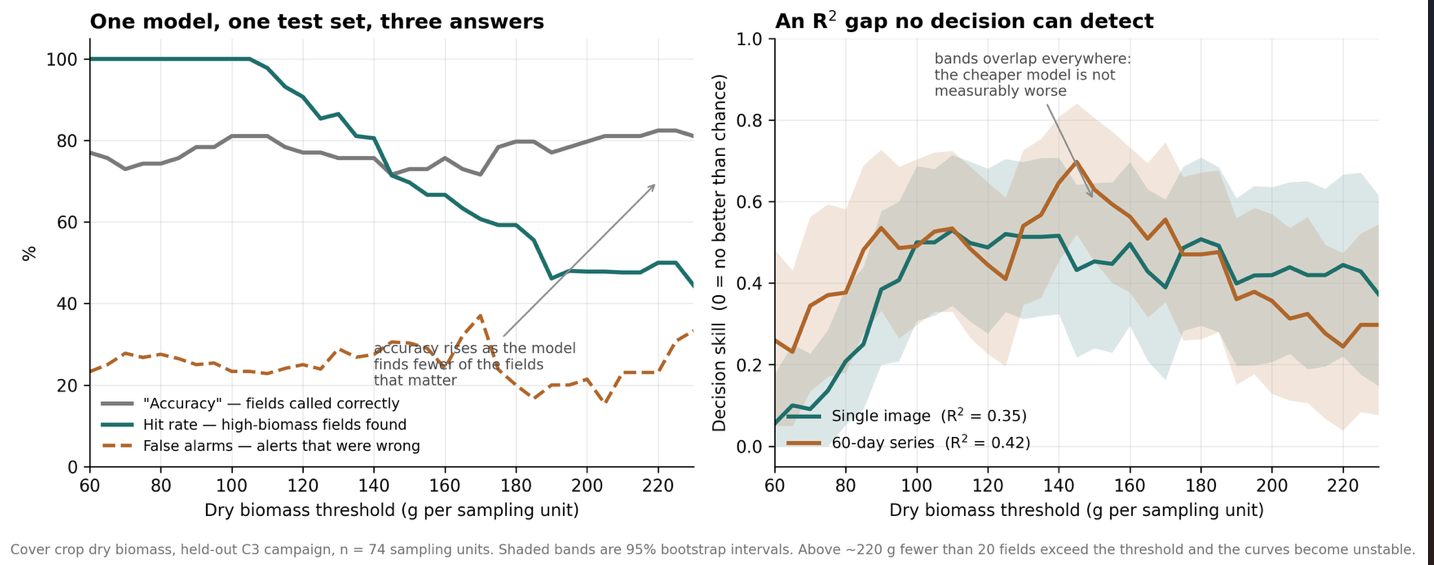
Izquierda: Un modelo puntuó de tres maneras a medida que cambia el umbral de decisión, con una precisión que aumenta a medida que disminuye la tasa de aciertos. Derecha: Dos modelos con una diferencia de 0,07 en R², cuyas bandas bootstrap 95% se superponen en todo el rango operativo. Fuente: Análisis de EarthDaily
¿Mejor que qué?
Existe una segunda pregunta que se formula aún con menos frecuencia, y para este sector, es más importante que la primera.
Cada afirmación sobre la precisión implica una comparación, y esta comparación suele quedar en blanco. Antes de poder afirmar que un modelo es bueno, es necesario saber a qué supera. Por definición, un R² de cero corresponde a predecir la biomasa media del conjunto de evaluación para cada muestra. Para una evaluación comparativa operativa, la comparación debería ser algo disponible antes de la predicción: un promedio histórico, la campaña anterior, la estimación de un agrónomo o cualquier otro dato que el comprador ya utilice.
Es la versión sobre la que un comprador puede actuar porque ya tiene una forma de hacerlo, ya sea mediante una muestra manual, el criterio de un agrónomo o el programa del año pasado.
Lee ese párrafo de nuevo, sustituyendo el modelo por un modelo biológico, y verás el principal obstáculo comercial del sector. La afirmación “El producto funciona” no es verificable tal como está planteada. En cambio, “Bajo estas condiciones de suelo, clima y tiempo, ofrece esta respuesta superior a la del programa actual, lo que compensa su coste por hectárea” sí es una afirmación que se puede hacer.
El desempeño inconsistente de los productos biológicos en el campo se suele abordar casi exclusivamente como un problema del producto. Sin embargo, gran parte del problema radica en la falta de evidencia. La replicación demuestra que un tratamiento funciona dentro de los entornos que representa una red de ensayos, lo cual no es lo mismo que demostrar que el efecto se transfiere a una nueva geografía, sistema de manejo o temporada.
La evidencia también tiende a llevar a una comparación errónea, ya que la respuesta en comparación con un grupo de control sin tratamiento demuestra que un producto tiene algún efecto, mientras que la decisión de compra se basa en lo que aporta al programa que el cultivador ya está implementando. Una variedad mejor no solucionará ninguno de estos problemas.
Cuatro preguntas
Esto no hace que las métricas de precisión sean inútiles, solo incompletas. Un número sin un protocolo no es una afirmación, es solo una forma. Por lo tanto, cuando alguien te muestra una cifra de precisión, cuatro preguntas te ayudarán a comprenderla casi por completo.
- ¿Qué te guardaste? ¿Una muestra aleatoria, un campo entero, una región, una temporada?
- ¿A qué le ganaste? No la media del conjunto de evaluación, que es solo el punto de partida de R², sino frente a lo que el comprador haga hoy, en las unidades del comprador.
- ¿Cuál fue tu peor caso, no el promedio?
- ¿Cuánto me cuesta una llamada equivocada? Solo el cliente puede responder a esta pregunta, ya que depende de su propia situación económica y no de ningún aspecto del modelo. Esto también hace que la pregunta sea útil en una reunión con un proveedor.
Dos proveedores pueden discrepar sobre dónde debería ubicarse el umbral sin que ninguno tenga que admitir que su modelo es defectuoso. Vale la pena consultar la documentación de su modelo.
¡Obtenga el boletín hoy!